大模型都有哪些
很多人一提到大模型,第一反应就是: 不就是像 ChatGPT 一样聊天的吗? 其实这只是大模型的一部分。 今天的大模型,已经不只是“会聊天”,而是可以处理多种不同类型的内容。
大模型都有哪些
大模型都有哪些
很多人一提到大模型,第一反应就是:
不就是像 ChatGPT 一样聊天的吗?
其实这只是大模型的一部分。
今天的大模型,已经不只是“会聊天”,而是可以处理多种不同类型的内容。
你可以把它理解成:
不同类型内容的 AI 处理器。
有的擅长处理文字,
有的擅长生成图片,
有的擅长做视频,
还有的能够直接帮你执行任务。
大模型不是单一工具,而是一整套能力体系。
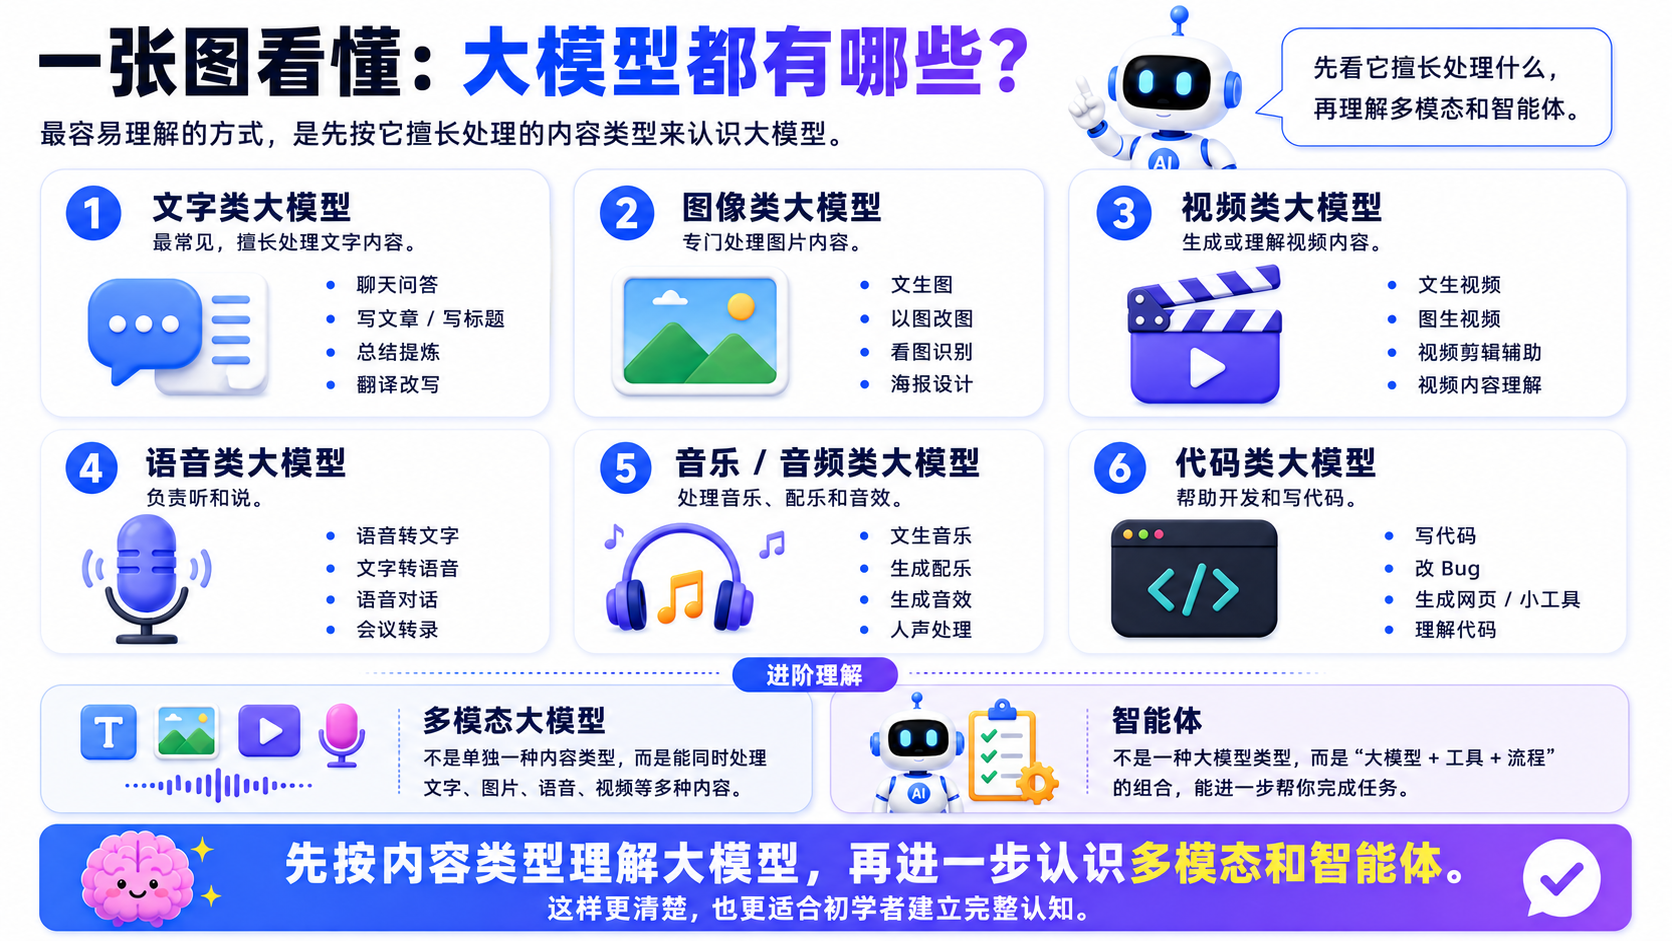
一、文字类大模型
这是目前大家最熟悉的一类大模型,它最擅长处理文字内容,比如:聊天问答,写文章,总结内容,翻译改写,提炼重点,生成方案等
像我们平时接触比较多的:Chatgpt,Claude,通义千问,豆包,Deepseek等 大多数都处于这一类,或者至少是以文字能力为基础的。
对于大部分人来说,文字类大模型最常见的用途就是:帮你“想”、帮你“写”、帮你“整理”。
二、图像类大模型
图像类大模型,主要负责处理图片。
它可以做的事情包括:
- 文生图:根据文字生成图片
- 以图改图:根据现有图片进行修改
- 修图补图
- 理解图片内容
- 根据图片生成描述
比如你输入一句:
帮我生成一张科技感的课程封面图
它就能直接生成图片。
对普通人来说,这类模型最实用的地方在于:
以前做图需要设计能力,现在很多时候只需要会描述需求。
三、视频类大模型
视频类大模型,是近两年发展很快的一类。
它主要处理视频相关任务,比如:
- 文生视频
- 图生视频
- 视频内容理解
- 视频剪辑辅助
- 视频生成和延展
比如输入一句话:
生成一个城市夜景的短视频
AI 就可能直接帮你生成一段画面。
这类模型的意义在于:
它让视频创作的门槛开始降低了。
过去做视频,需要拍摄、剪辑、配音、配乐。
未来很多内容,可能只需要“会表达想法”。
四、语音类大模型
语音类大模型主要处理“听”和“说”。
它可以做的事情包括:
- 语音转文字
- 文字转语音
- 语音对话
- 会议转录
- 语音理解
比如:
- 把一段录音整理成文字
- 把文章变成配音
- 和 AI 直接进行语音交流
对很多办公场景来说,这类模型特别有用。
比如开会、做笔记、做课程、做短视频,语音类能力都会大量用到。
五、音乐 / 音频类大模型
这一类主要处理音乐、配乐和音效。
它可以做的事情包括:
- 文生音乐
- 生成配乐
- 生成音效
- 人声处理
- 音频优化
比如:
生成一段轻松、科技感的背景音乐
AI 就能自动帮你做出来。
这类模型虽然没有文字模型那么普及,但在短视频、课程、广告、配音场景里,价值会越来越大。
六、代码类大模型
代码类大模型,主要是帮助编程和开发。
它能做的事情包括:
- 写代码
- 改 Bug
- 解释代码
- 生成网页
- 生成小工具
- 辅助开发
像你现在的 Codex、Cursor、Claude Code,这些就和代码类大模型高度相关。
对程序员来说,它像一个开发助手。
对普通人来说,它的意义更大:
即使你不会写代码,也可以借助 AI 做出一些简单的软件、小工具或自动化流程。
七、多模态大模型
多模态大模型,指的是它不只会处理一种内容,而是能同时处理多种内容。
比如它既能看文字,也能看图片;
既能听语音,也能理解视频。
它可以完成:
- 看图回答
- 读文档和表格
- 听语音做理解
- 综合分析多种信息
这类模型的重要意义在于:
它更接近人类处理信息的方式。
因为现实生活中,我们面对的从来不是单一信息,而是文字、图片、语音、视频混合在一起的。
八、决策 / 智能体能力
这部分其实可以理解为:
大模型不再只是“回答问题”,而是开始“帮你做事”。
它可以做的事情包括:
- 拆解任务
- 制定步骤
- 调用工具
- 自动执行流程
- 输出最终结果
比如你告诉 AI:
帮我做一份市场分析报告
未来它可能不是只给你一段回答,而是会:
- 先理解任务
- 再搜索资料
- 整理数据
- 生成文档
- 最后把结果交给你
这就是从“大模型”走向“智能体”的方向。
也就是说,AI 正在从一个工具,逐步变成一个助手,甚至是一个执行者。